智能体 RAG:大语言模型应用的新模式
智能体RAG突破传统RAG一次性检索的局限,让大模型具备“推理-行动”能力:可基于初步结论动态调用检索工具、跨源交叉验证,实现多轮查证与迭代思考,显著提升回答的全面性与准确性。

如何用 AI 制作专辑封面
Freepik 新增 AI 专辑封面生成功能,支持从提示词生成到后期编辑的一站式设计。文中以电子音乐为例,给出“宇航员漂浮太空、漫画风格、黑白蓝配色、星体背景”等实用提示词,助音乐人快速产出专业级封面。

如何通过 AI 制作动态光影背景视频
用Freepik或可灵输入英文提示词,即可一键生成融合80年代怀旧美学与现代动感的动态光影视频:光晕扩散、胶片颗粒、VHS失真、霓虹色差等效果自然流畅,适配品牌宣传、影视游戏及舞台设计等多场景需求。
川崎重工发布新型机器座骑:CORLEO
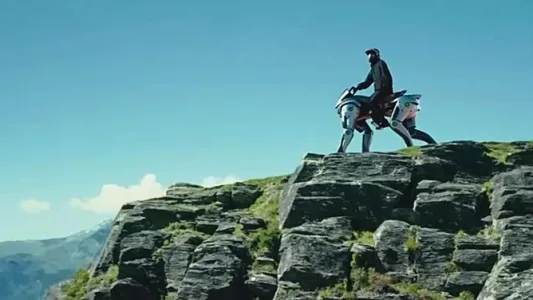
川崎重工在关西世博会发布氢动力四足机器人座骑CORLEO,灵感源自摩托车设计,通过骑手重心偏移实现自然操控;搭载150cc氢引擎与独立驱动机械腿,可越野越障、跳跃障碍;配备HUD实时显示氢量与稳定性,目前为概念验证阶段。
Llama 4 开源大模型家族:开启原生多模态 AI 创新的新时代
Meta开源Llama 4系列,含Scout(1000万Token上下文)、Maverick及训练中的Behemoth,原生支持文本、图像、视频多模态理解;采用MoE架构提升效率,多语言训练规模达Llama 3的10倍,安全与偏见控制显著优化。

Midjourney v7 及其他优秀 AI 绘画模型对比
AI创作者Marco用高精度时尚摄影提示词,横向测试Midjourney v7、v6.1及Ideogram 3.0等十余款主流模型。结果显示,v7在人像细节刻画、服饰纹理还原与胶片色调一致性上明显提升,尤其对复杂光影和混搭风格的把控更稳,适合追求质感的商业级图像生成。

Midjourney v6.1 和 v7 的对比测试
Midjourney v6.1 与 v7 在写实人像、幻想角色、赛博朋克城市等九类典型场景下同 prompt 对比测试,统一启用 --raw --stylize 400。v7 在细节还原、材质表现与情绪氛围上提升明显,尤其在复杂光影、多材质叠加和动态构图中更稳定;v6.1 则在部分极简与风格化表达中仍有独特控制力。

如何通过 Freepik 自动更换图片的背景
Freepik 新增智能背景更换功能,无需手动抠图即可自动识别并替换人物或物体背景;系统还能自适应调整主体光影,使其与新背景自然融合,操作简单、效果逼真,大幅提升设计效率。

如何通过 Freepik 轻松制作产品展示图片及视频
Freepik 新增产品建模功能:上传15–20张多角度实物图,即可生成可编辑的3D风格产品模型;支持文本提示更换背景,并联动可灵一键生成展示视频,大幅降低电商视觉内容制作门槛。