
#图像生成

GPT-4o 完美保持画面主体一致性
GPT-4o 在图像生成中显著提升主体一致性,同一角色可自然适配低多边形、桌游模型、水晶雕塑等不同风格,无需重复描述细节。它更懂用户意图,让AI绘画从工具升级为具备理解力与表现力的“数字画师”。

GPT-4o 让 AI 绘画真正具备实用价值
GPT-4o 原生图像生成支持单图精准呈现15个不同属性物体,远超DALL·E的5–8个上限;细节把控能力显著提升,使AI绘画从“视觉可用”进阶为“任务可用”,切实支撑创意落地与高效人机协作。

GPT-4o 制作透明背景图片
GPT-4o 支持直接通过自然语言指令(如“生成一张透明图片”)生成带 Alpha 通道的透明背景图像,无需手动抠图或后期处理;还可结合文字描述添加滤镜效果,实现端到端的图像生成与轻量编辑。

GPT-4o 超级文字渲染功能
GPT-4o 实现高精度图像内文字渲染,生成的文字不仅清晰可读,更与画面语义高度一致。这一能力突破了AI绘画长期存在的文字表达瓶颈,让对话漫画、信息图表等需图文协同的创作真正落地,大幅提升实用性。
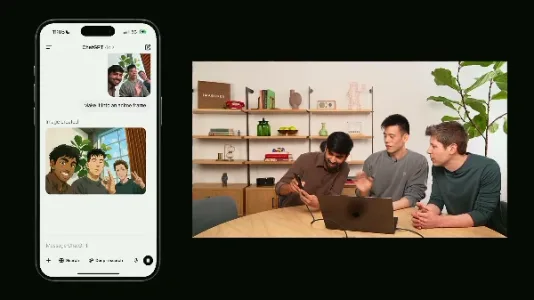
OpenAI 发布 GPT-4o 原生图像生成功能
OpenAI 为 GPT-4o 推出原生图像生成功能,成为继 Gemini、Grok 3 后第三款全能多模态模型。支持文生图、风格迁移、带准确文本的图像生成、教育漫画创作、个性化设计及多轮编辑,兼顾创作自由与实用性,图像质量优异,速度将持续优化。

一款结合了 Gemini 绘画功能的联合涂鸦工具
这是一款基于Gemini原生绘画能力的实时协同涂鸦工具,支持在绘图过程中用自然语言指令增删、调整元素,实现人机协作式创作。无需安装,开箱即用,直接在Hugging Face空间访问体验。
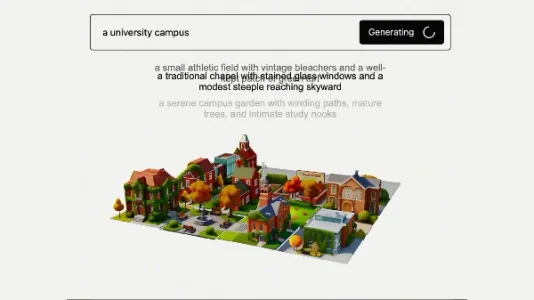
SynCity:开创无需训练的 3D 世界生成新范式
SynCity 是牛津大学提出的一种无需训练的 3D 世界生成方法,通过协同调用预训练的 2D(Flux)与 3D(TRELLIS)模型,以逐块生成、跨维转换和迭代混合的方式,构建连贯可探索的 3D 环境。它绕开传统高成本训练流程,显著提升生成效率与通用性,适用于多样化文本驱动的场景构建。

Google 推出 Gemini 2.0 Flash 原生图像生成功能
Google 正式向所有支持地区开发者开放 Gemini 2.0 Flash 原生图像生成功能,可在 Google AI Studio 和 Gemini API 中调用。它支持文本生成图像、对话式实时编辑、常识推理保障内容合理性,并显著提升图像中文字渲染的准确性,适用于故事配图、广告设计等场景。

如何通过 Gemini 2.0 创作图像小说和电影分镜
Gemini 2.0 已深度集成 Imagen 图像生成能力,支持用自然语言(含中文)连续生成风格、人物、场景一致的分镜图像。Anu Aakash 仅凭情节描述、镜头要求与闪回指令,就高效产出多组电影级分镜,零绘画基础也能完成图像小说与影视前期创作,现通过 Google AI Studio 或 Gemini 免费使用。