
Freepik 整合六大 AI 视频生成模型,具备高性价比
Freepik 新增整合 Runway、海螺 AI、Luma、可灵、Mochi 和混元六大 AI 视频生成模型,支持一站式切换调用;年度基础会员仅 5.75 美元/月,全年可生成 8.4 万张图与 560 段视频,中小创作者可低成本试用多模型效果。
GPT-5 早已存在,而且已经在暗中影响着世界
有迹象表明,GPT-5可能已被OpenAI内部训练并用于模型蒸馏——类似Anthropic用未发布的Claude Opus 3.5提升Sonnet 3.6性能。这种“不发布、只内用”的策略,正推动大模型竞争从追求参数规模转向优化性价比与协同增益。
能够融合声音的小型 TTS(文本转语音)模型:Kokoro
Kokoro 是仅 82M 参数的轻量级 TTS 模型,支持从十种预设声线中任选两种,按任意比例混合生成个性化语音——如男女声 60:40 融合。提供简洁 API,访问 kokorotts.com 即可快速调用。
Veo 2 遵循摄影测量技术,使得 3D 摄像机跟踪成为可能
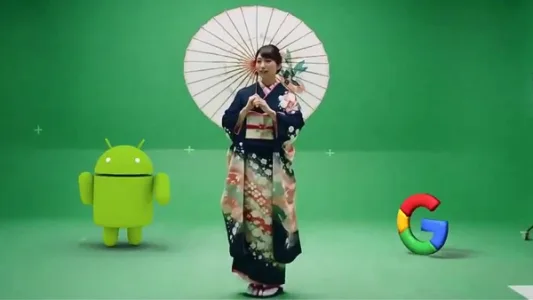
Google Veo 2生成的视频符合摄影测量原理,可精准提取3D摄像机运动数据,让安卓机器人、樱花场景等虚拟元素自然融入AI视频,无需改造现有特效工作流,为影视后期提供即插即用的AI协作新路径。

Krea.ai 实现将 2D 图像转化为 3D 对象
Krea.ai 上线免费 2D 转 3D 功能,可将任意平面图像生成可交互的 3D 模型,并支持在原图背景中自由移动、旋转;背景自动适配主体姿态变化,实现自然流畅的动态视觉效果。
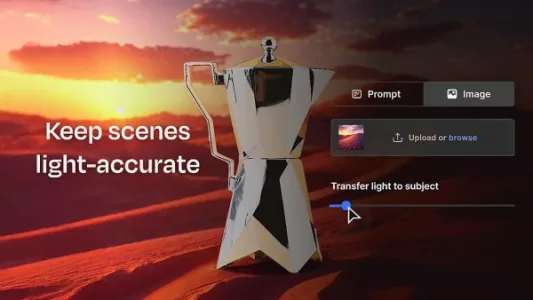
Freepik 推出全新背景更换功能
Freepik 新增智能背景更换功能,支持一键替换图片背景;依托 Relight 技术自动匹配主体与新背景的光影关系,显著提升合成真实感,适合设计师快速产出高质量视觉内容。
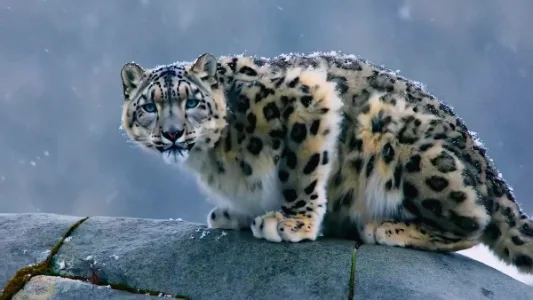
Luma 发布新一代视频生成模型 Ray2
Luma 推出新一代视频生成模型 Ray2,计算规模达 Ray1 的 10 倍,文本理解与事件逻辑建模能力显著提升,可快速生成动作连贯、细节逼真、结构合理的视频,生成成功率与实用性大幅提高,现已向所有用户开放。
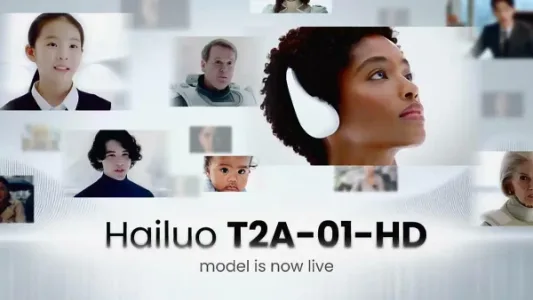
海螺 AI 推出全新文生音频功能 T2A-01-HD
海螺AI上线文生音频模型T2A-01-HD,10秒即可克隆声音并保留情感细节;支持300+预设语音与17种语言及方言口音;内置情感智能系统,可自动或手动调节语气、语速、音调,并添加房间声学等专业效果,显著提升AI影片制作效率。
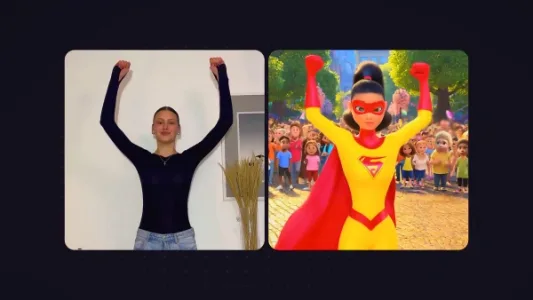
AI 视频人物动作精准控制工具:Kinetix
Kinetix 是一款专注动作控制的 AI 视频工具,能将上传表演视频中的人体动作精准迁移至生成角色,突破当前仅支持口型/表情同步的局限;用户只需输入场景提示词并上传动作引导视频即可使用,现开放官网等候名单注册。