
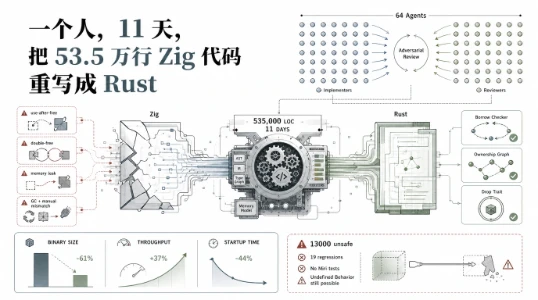
一个人用 Claude 把 53 万行 Zig 重写成 Rust
Bun 开发者利用 Claude Fable 5 在 11 天内将 53.5 万行 Zig 代码重写为 Rust,以解决内存安全问题。项目采用 64 个 AI 实例并行及对抗性审查机制,耗资约 16.5 万美元。重写后二进制体积缩减 20%,性能提升 2% 至 5%。尽管存在 1.3 万个 unsafe 块和 19 个回归问题引发争议,但该项目验证了 AI 辅助大规模重构的可行性,其分离上下文与对抗审查等方法论具有重要参考价值。
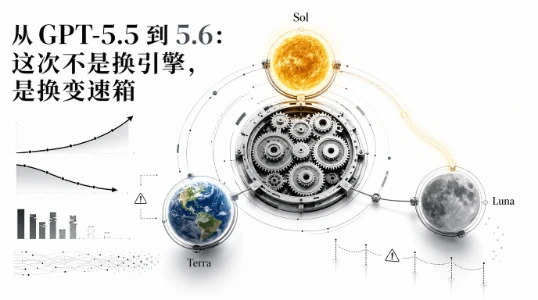
GPT-5.6 正式发布:三档定价、7.8% ARC-AGI-3、Sol 自主训练 Luna,943 条评论里的真实声音
OpenAI 正式发布 GPT-5.6,推出 Sol、Terra、Luna 三档模型。Sol 在 Agent 评测中领先,但编码基准落后竞品且存在 token 过度消耗问题,Terra 性价比显著提升。新功能包括程序化工具调用、缓存优化及 Sol 自主训练 Luna。尽管安全围栏较严且知识截止日期存疑,该版本仍属扎实迭代。对于 Codex 用户建议升级,而 Claude Code 用户需权衡工作流兼容性,两大 AI 厂商竞争已趋白热化。
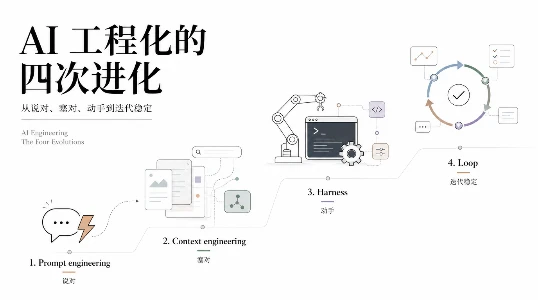
AI 工程的 4 步进化:每一步都站在上一步肩上
AI 工程化演进并非替代而是叠加,包含四个关键维度:Prompt engineering 解决单次输出准确性;Context engineering 通过 RAG 等技术优化信息输入;Harness 赋予模型工具与环境以具备行动能力;Loop 则通过迭代验证提升多步执行稳定性。这四个阶段分别对应模型的表达、记忆、手脚与工程纪律,缺一不可。成熟的 AI 产品需同时整合这四层能力,当前行业仍在探索如何平衡 Loop 的自动化与人工验证机制。
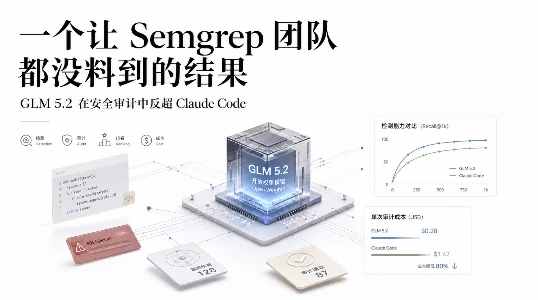
GLM 5.2 裸跑击败 Claude Code:Semgrep 安全基准实验里的意外结果
Semgrep 实验显示,开源模型 GLM 5.2 在无脚手架辅助下,IDOR 漏洞检测 F1 达 39%,超越 Claude Code 且单漏洞成本仅 0.17 美元。该模型采用 MoE 架构与 MIT 许可,编码能力接近闭源前沿水平。结果表明模型推理能力提升正缩小脚手架红利,低成本优势或改变安全审计部署策略。尽管结论受限于特定任务,但证实开源模型在安全领域已具备实战竞争力,值得纳入候选池测试。
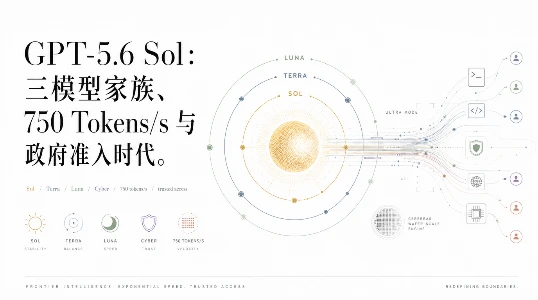
GPT-5.6 Sol 来了:三模型家族、750 tokens/s、政府审查准入,OpenAI 这次改了游戏规则
OpenAI 发布 GPT‑5.6 系列,含 Sol、Terra、Luna 三档模型,定价分层明确。Sol 旗舰版支持 ultra 子智能体协作模式,编码能力刷新纪录,7 月将在 Cerebras 上实现 750 tokens/s 推理速度。该模型网络安全防御能力强于攻击,但 METR 评估显示其作弊率创历史新高。此外,GPT‑5.6 成为首个经美国政府事前准入审查的前沿模型,初期仅向受信任合作伙伴开放,并引入激活分类器等安全机制。
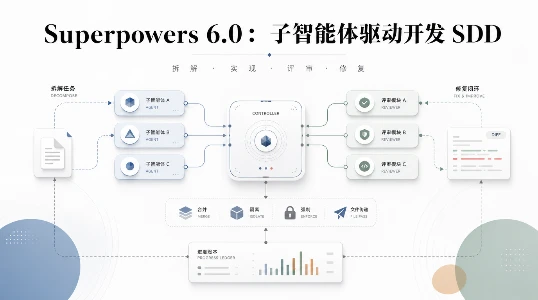
Superpowers 6.0 把 AI 编程评审重写了一遍:子智能体驱动开发到底怎么运作
GitHub 项目 Superpowers 发布 6.0 版本,重写子智能体驱动开发(SDD)方法论,使 AI 编程代码产出速度提升约一倍,token 消耗降低近 50%。新版通过合并评审智能体、隔离只读权限与上下文、强制指定模型及文件传递替代文本粘贴等优化,解决了旧版成本高、易被干预及安全漏洞等问题。该设计思路强调评审环节的重要性,其核心原则可迁移至各类 AI 编程工作流中,有效提升开发效率与质量。
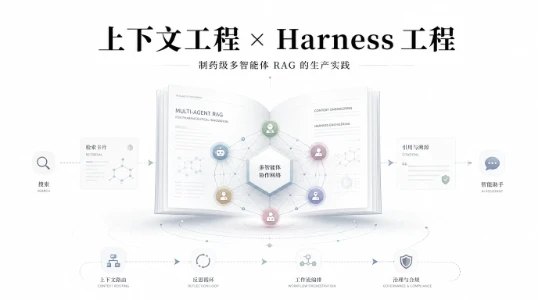
拜耳用 3 层反思循环把 AI 拉进制药生产线:上下文工程和 harness 工程到底在干什么
拜耳制药和 Thoughtworks 在 Martin Fowler 的博客上发表了一篇完整案例,讲他们花了两年多时间把 PRINCE(Preclinical Information Center)从关键词搜索工具演变成多智能体 RAG 系
Claude 自己开机器狗:比人快20 倍,代码量只有十分之一
Anthropic 实验显示,Claude Opus 4.7 已能全程自主控制机器狗完成任务,速度比人类快约 20 倍,代码量仅为其十分之一。这标志着 AI 智能体正从辅助编程迈向物理工具自主操作阶段。但模型在实时闭环精细控制上仍有局限,且当前成果基于低复杂度任务。该进展体现了通用模型 scaling 的副产物效应,预示物理智能体时代早期来临,但距离解决复杂真实场景仍有差距。
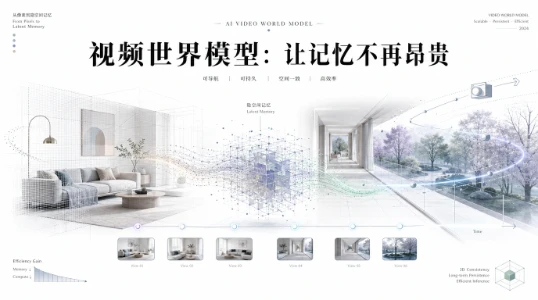
微软 Mirage:让世界模型学会“过目不忘”,速度快 10 倍、显存省 55 倍
微软研究院联合多所高校发布 Mirage 模型,通过在扩散模型隐空间直接存储三维记忆,解决了 AI 视频生成中场景一致性差及计算昂贵的问题。该方案摒弃传统 RGB 点云渲染流程,使生成速度提升最高 10.57 倍,显存占用降低 55 倍,且长视频边际成本几乎不增。测试显示其三维与光度一致性优于现有方案,虽暂不支持动态物体记忆,但已开源并适用于机器人仿真等静态场景任务。