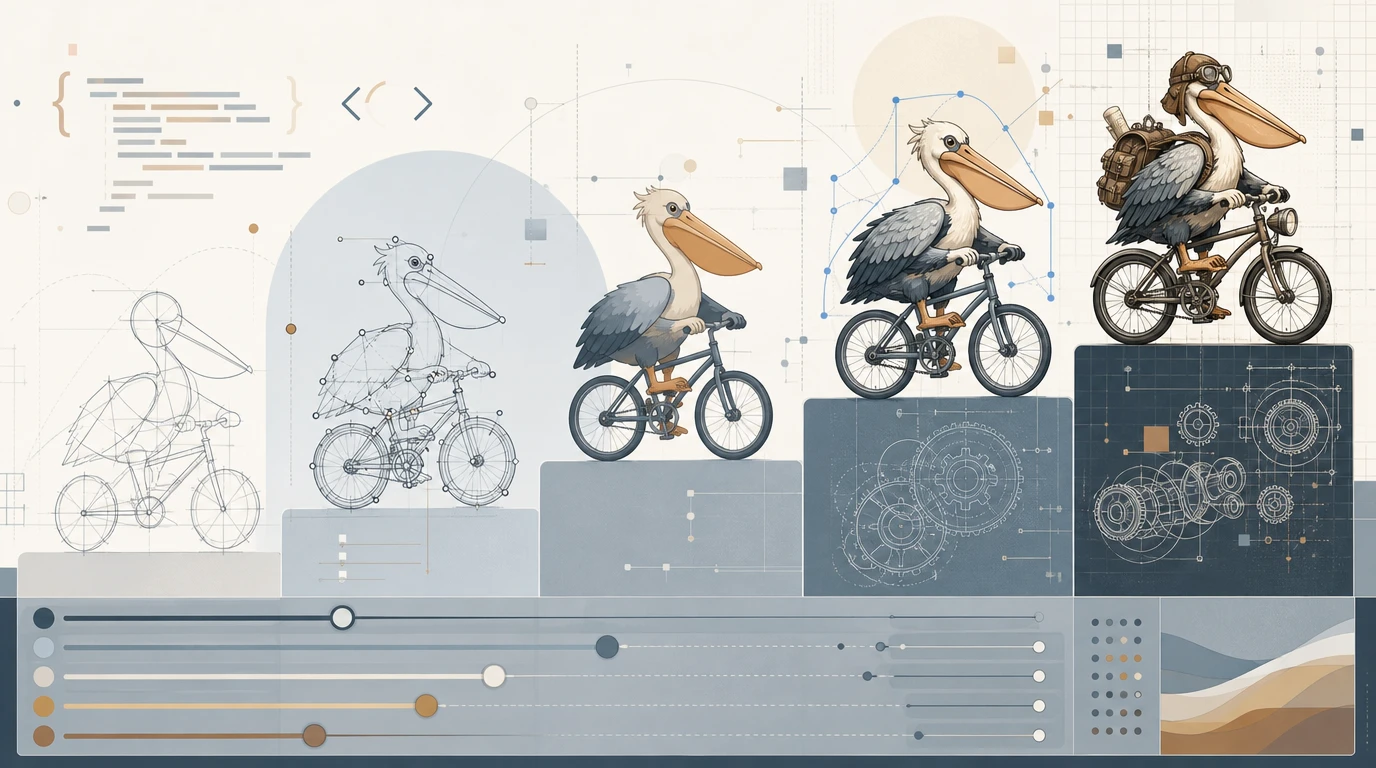
一张提示词完全相同的“骑自行车的鹈鹕”矢量图(SVG),在 Claude Fable 5.1 模型中可以花费 10 美分在 23 秒内完成,也能消耗 3.30 美元耗时近 14 分钟精雕细琢。表面看这是推理耗时与 API 账单的线性膨胀,本质是大语言模型在代码几何空间内从“语法级模板直出”向“物理碰撞与空间布局多步推演”的范式跃迁。
Anthropic 在新发布的 Claude Fable 5.1 中引入了分档推理机制(reasoning effort,即模型在生成最终代码前进行隐式思考的算力配额),并不再允许完全关闭推理。这一机制彻底改变了前端矢量资产与生成式 UI 代码的产出逻辑。
五档推理等级的算力跃迁与出图表现
Fable 5.1 提供了五个推理档位:low、medium、high、xhigh、max。在实测中使用统一提示词 "Generate an SVG of a pelican riding a bicycle"(生成一只骑自行车的鹈鹕的 SVG 代码),不同档位的表现呈现出断层式差异。
# 使用 Simon Willison 的 llm 命令行工具调用不同推理等级
llm -m claude-fable-5.1 -o reasoning_effort low "Generate an SVG of a pelican riding a bicycle"
llm -m claude-fable-5.1 -o reasoning_effort max "Generate an SVG of a pelican riding a bicycle"
在 low 档位下,模型输出 1998 个 tokens,耗时 23.8 秒,产生 10.017 美分成本。画面呈现一只白色身躯、橙色喙的鹈鹕向左骑行,虽然腿部踩在脚踏上,但整体线条属于基础几何拼贴,缺乏光影层次。
medium 档位输出了 1977 个 tokens,耗时 23 秒,成本 9.912 美分。出图仅是将朝向换到了右侧,复杂度并无提升。实测数据显示 low 与 medium 档位几乎跳过了显式推理阶段,两者的 token 消耗和生成质量基本重合。
转折点出现在 high 档位。模型输出 2612 tokens,耗时 29.6 秒,花费 13.087 美分,推理链路(reasoning trace)中开始出现对画布 viewBox 与自行车骨架的初步布局规划。
进入 xhigh 档位后算力呈现爆发式增长:输出达到 36767 tokens,运行 7 分 51 秒,成本跃升至 1.83 美元。模型在思考过程中显式设定了“让鹈鹕体型略大于自行车以营造喜剧感”的构图意图。
最高档位 max 输出了 65927 tokens,耗时 13 分 54 秒,单次生成成本达到 3.30 美元。生成的 SVG 具备极高的视觉完成度:背景具备渐变与地平线设计,鹈鹕头戴蓝色遮阳帽,双腿分别位于车架两侧且脚掌精准贴合踏板,前车篮内甚至增加了一条作为食物的鱼。
| 阶段 | 核心问题 | 留下的硬伤 |
|---|---|---|
| 低算力试水(low / medium) | 空间图层缺乏预先规划,按顺序直接拼接代码 | 肢体与车身无遮挡关系,图层穿模严重,无环境光影 |
| 结构平衡期(high / xhigh) | 坐标对齐耗费大量思考 token,排查代码语法 | 元素间比例偶尔失调,构图偶发机械性僵硬 |
| 极度推演期(max) | 算力边际效益递减,反复调整贝塞尔曲线控制点 | 耗时接近 14 分钟,单图 API 成本高昂无法用于高频交互 |
深入推理链:AI 是如何在代码空间做“碰撞检测”的
大语言模型生成矢量图形与栅格扩散模型(Diffusion)截然不同。扩散模型是在潜在像素空间去噪,而 LLM 必须在纯文本中计算绝对坐标(x, y)与三次贝塞尔曲线控制点(cubic Bézier curves)。
在 max 档位记录的完整推理链路(trace)中,可以看到 Fable 5.1 如何像一名严谨的工程师一样工作:它先规划画布布局,再逐层添加元素,并反复检查元素间的空间关系。推理过程中出现了“喙的坐标 (484,84) 会与头盔弧线重叠,需要把头盔缩小到只覆盖头顶,并调整弧线端点使其更高更窄,让喙能干净地接在前方”这样的碰撞检测逻辑。
它还处理了更细的视觉决策:在“给鹈鹕加一条围巾还是帽子”之间权衡,最终选择帽子以强化自行车主题;在绘制翅膀时,把尾缘从平滑曲线改为扇贝形羽毛曲线以更自然;甚至检查了前叉曲线的控制点方向——当前控制点让形状向后倾斜时,它主动把控制点向右移动以修正前叉的倾斜。
这种“先规划、再绘制、后校验”的推理模式,正是高推理档位能产出高质量 SVG 的根本原因。它不再是一次性把代码拼出来,而是像人类设计师一样在脑中反复推演空间关系。
管道工作流:从静态矢量到原生动态交互
推理等级的价值不止于静态出图。Simon Willison 在 Hacker News 上看到“既然鹈鹕基准已解决,能不能做动画版”的评论后,把 max 档位生成的鹈鹕 SVG 通过管道直接传给模型做动画:
# 把上一条生成的 SVG 通过管道传给模型做动画
llm logs -cx | llm -m claude-fable-5.1 -s 'animate this'
这次调用消耗 6121 输入 tokens、26201 输出 tokens,成本 1.37 美元,生成了轮子转动的动画 SVG。虽然转成 MP4 时轮子旋转方向反了(这是转换工具的伪影,原始 SVG 方向正确),但整个流程证明了:推理等级 + 管道工作流,可以让模型在已有代码基础上做增量创作,而不是每次从零生成。
这种“先生成静态资产,再管道化做动态增强”的工作流,对做前端动效、数据可视化、生成式 UI 的开发者尤其有用。它把一次性的图像生成,变成了可迭代的代码资产管线。
推理档位选择的工程实践边界
从实测数据看,推理档位选择本质是“质量、成本、延迟”的三方权衡。低档位(low / medium)适合快速原型、批量生成、对质量要求不高的场景,10 美分左右的成本让高频调用成为可能。但要注意,这两个档位可能完全跳过推理,出图质量接近。
high 档位是性价比甜点:13 美分、30 秒内出图,且开始有布局规划,适合大多数日常开发场景。xhigh 和 max 则适合对视觉完成度有极致要求的场景——比如品牌资产、演示素材、需要精细空间关系的复杂图形——但 1.8 到 3.3 美元的成本和 8 到 14 分钟的延迟,决定了它们不适合高频交互。
一个实用建议:先用 low 或 medium 快速验证构图方向,确认满意后再用 high 或 max 精修。这样既避免了在错误方向上浪费高成本推理,又能拿到最终的高质量结果。
综合判断与未解决的问题
需要澄清一个常见误解:推理等级越高,并不代表模型“更聪明”,而是代表它被允许花更多算力在“思考”上。Fable 5.1 的 low 和 medium 档位几乎不推理,high 才开始有显式规划,xhigh 和 max 则进入深度推演。这意味着推理等级更像是一个“算力预算旋钮”,而不是“能力开关”。
另一个值得注意的对比:Simon Willison 认为 Fable 5.1 生成的 SVG 在“风格感”(flair)上仍不如 Gemini 3.7 Flash,但 Fable 5.1 更忠实于“生成一个 SVG”的指令本身。这说明不同模型在“忠实执行”与“创意发挥”上有不同取向,选择模型时应考虑你的核心诉求。
尚未解决的问题是:推理等级与出图质量并非严格线性。low 和 medium 几乎重合,而 xhigh 到 max 的边际提升是否值得 1.5 美元的成本差,取决于具体场景。目前缺乏一个“质量-成本”的量化评估框架,开发者只能靠实测摸索。此外,推理 trace 的完整记录依赖工具支持(Simon 为此修复了 llm-anthropic 的一个 bug),普通用户可能看不到这些宝贵的思考过程。
引用来源
- Simon Willison. "Claude Fable 5.1 made me a really nice animated pelican". 2026-09-01. https://simonwillison.net/2026/Sep/1/claude-fable-5-1/
- Anthropic. "Claude Fable and Mythos 5.1". 2026-09-01. https://www.anthropic.com/claude-fable-and-mythos-5-1
- Simon Willison. "Understanding ChatGPT Work". 2026-08-30. https://simonwillison.net/2026/Aug/30/understanding-chatgpt-work/
- Simon Willison. "llm-anthropic: Plugin for LLM adding support for Anthropic models". 2026-09-01. https://github.com/simonw/llm-anthropic
- Terminal-Bench Team. "Terminal-Bench-Science 0.1 Benchmark Release". 2026-08-27. https://www.terminal-bench-science.ai/