
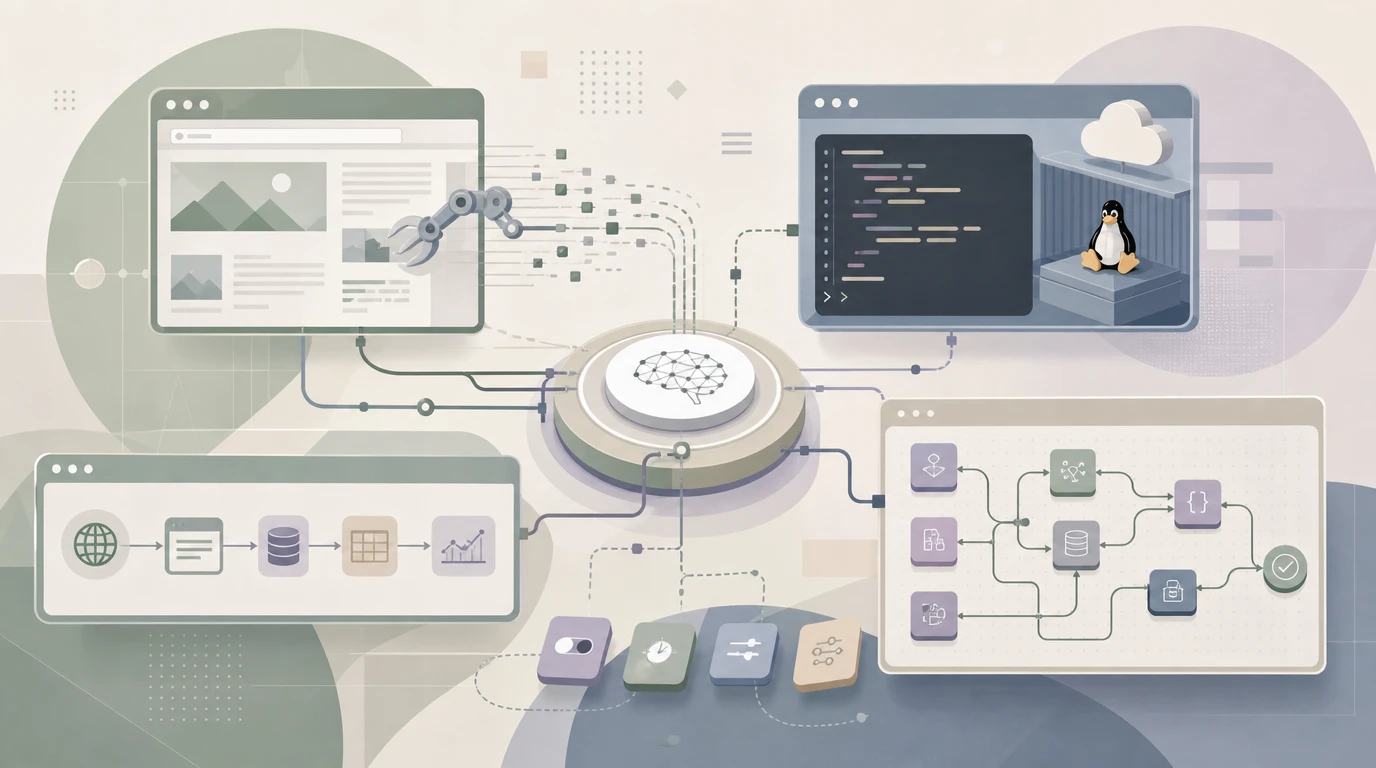
Simon Willison 在 2026 年 8 月 30 日的实测报告中,把 ChatGPT Work 拆成了两个产品:云端版(Work Cloud)和桌面版(Work Local),并总结出它比普通 Chat 多出的 7 大能力。表面看这只是给网页对话框增加了无头浏览器(Headless Browser,即没有图形界面的后台网页浏览器)与代码执行环境,本质是将大语言模型下沉为能够调度底层系统资源的自动化中枢。
过去的 AI 脚本往往受限于单次运行超时与环境重置,开发者必须反复复制代码到本地调试。如今 ChatGPT Work 智能体将 Linux 容器、浏览器自动化框架与长周期任务调度集成在云端,用户通过结构化提示词就能直接交付复杂的多步任务。
| 阶段 | 核心问题 | 留下的硬伤 |
|---|---|---|
| 纯文本对话时代 | 无法执行代码与访问外部动态数据 | 幻觉率高且完全依赖人工复制粘贴 |
| 早期代码解释器时代 | 会话断开即销毁环境且无公网权限 | 无法保持依赖库状态,不支持异步长任务 |
| Work 智能体时代 | 异步系统调用与真实网络交互被打通 | 长任务异常重试机制仍需人工提示词兜底 |
环境基建:持久化沙盒与依赖自动化装配
ChatGPT Work 智能体的底层是一个包含完整包管理器的持久化容器。用户无需手动配置本地 Docker 镜像,只需声明环境需求,智能体便会在后台自动解析依赖树并完成编译。
用法 1:动态装包与环境状态留存
在处理地理空间数据或音视频文件时,常规解释器常因缺少系统级动态链接库而报错。Work 模式允许智能体自主执行系统包管理命令,并把安装状态固化在当前工作空间。
【提示词模板】
你现在处于 ChatGPT Work 沙盒环境中。请执行以下步骤:
1. 检查当前容器是否安装了 ffmpeg 和 libspatialindex。若未安装,请静默调用包管理器完成安装。
2. 创建一个虚拟环境,安装 geopandas、shapely 以及 moviepy 库。
3. 编写自检脚本验证动态链接库是否能够正常加载,输出验证成功的 JSON 报告。
4. 保持该环境处于可用状态,后续任务将直接调用上述依赖。
智能体会先通过后台终端运行环境检测,遇到依赖缺失时自动执行编译与安装。这种环境自治能力让用户跳过了繁琐的环境配置阶段,直接进入业务处理。
用法 2:跨语言管道协同处理
复杂数据流水线通常需要结合 Python 的生态与 Node.js 的前端渲染能力。Work 智能体支持在单个工作空间内跨进程调用多种运行时,实现多语言协同。
【提示词模板】
请在当前沙盒中实现跨语言管道:
1. 用 Python 抓取本地 sample.csv 数据并完成离线异常值过滤,将清洗后的结构化矩阵写入内存共享管道。
2. 启动 Node.js 脚本读取管道数据,调用内置的 Vega-Lite 渲染引擎生成 SVG 图表。
3. 将 SVG 图表转换为高分辨率 PNG 图像并保存在 /output 目录中。
用户不需要编写复杂的进程间通信逻辑,智能体会自动处理标准输入输出的重定向与临时文件生命周期管理。
动态抓取:无头浏览器配合上下文接管
传统的 HTTP 请求库无法应对大量依赖客户端 JavaScript 渲染的应用。Work 智能体内置了由模型直接控制的无头浏览器,能够模拟完整的人类交互行为。
用法 3:动态单页应用的长图截取与结构化抽取
面对带有复杂瀑布流和反爬策略的动态页面,智能体可以通过浏览器内核直接执行页面滚动、等待网络空闲并抓取 DOM 树。
【提示词模板】
启动无头浏览器访问目标 URL:https://example.com/analytics
执行以下操作:
1. 设置视口大小为 1920x1080,等待页面首屏加载完成。
2. 模拟向下平滑滚动,直到页面底部的动态数据全部渲染完毕。
3. 拦截所有包含 /api/v2/stats 的网络响应,将返回的 JSON 数据聚合并解析为 Pandas DataFrame。
4. 对渲染完成的完整仪表盘执行全页面截屏,保存为 dashboard.png。
智能体在此过程中不仅充当抓取脚本编写者,还会根据浏览器上报的页面状态动态调整等待时长。 如果遇到动态加载延迟,它会自动注入重试逻辑,避免拿到空数据。
用法 4:带状态的表单批量填充与凭证复用
对于需要身份校验的内部系统,Work 智能体可以加载用户提供的临时 Session 凭证,在浏览器上下文中维持登录状态并执行多步骤流转。
【提示词模板】
使用无头浏览器完成以下批量提交任务:
1. 载入提供的 session_cookie.json,注入到测试系统域名下。
2. 访问 https://internal.example.com/form-entry,确认是否成功跳过登录页面。
3. 读取 /data/records.json 中的 50 条待录入数据,依次定位页面输入控件完成表单填充与提交。
4. 记录每条提交返回的业务流水号,若某条记录遇到弹窗拦截,截图记录错误并继续下一条。
这避免了传统 RPA(Robotic Process Automation,机器人流程自动化)工具因网页结构微调而导致脚本整体崩溃的缺陷,智能体具备根据 DOM 语义自适应调整选择器的能力。
定时调度:长周期自动化脚本托管
脱离了即时对话的限制,Work 智能体能够接收未来时间维度的指令,将交互转变为后台守护进程。
用法 5:API 接口巡检与自适应异常告警
开发者可以让智能体在后台挂载轻量级调度器,对关键业务端点进行健康检查。
【提示词模板】
请在后台创建一个持续运行的巡检守护进程:
1. 每隔 15 分钟向 https://api.example.com/health 发送一次健康检查请求。
2. 记录响应延迟与 HTTP 状态码。如果连续 2 次延迟超过 1500 毫秒或状态码非 200,触发异常分析。
3. 异常触发时,自动调用无头浏览器抓取服务状态页,并生成诊断报告保存到 alert.log。
4. 运行周期为 8 小时,任务结束时生成完整的健康度统计折线图。
智能体会利用容器内置的 cron 或后台多线程机制挂起任务,并在预设触发点唤醒执行,大幅降低了搭建专用监控服务的成本。
用法 6:多源信息定时聚合与自动化排版
对于内容创作者和分析师,可以将日常搜集任务完全移交至后台。
【提示词模板】
设定每日定时任务:
1. 每天上午 9 点访问预设的 5 个技术资讯源(包含 RSS 与特定网页)。
2. 提取最近 24 小时内发布的 AI 智能体主题文章,剔除广告与重复报道。
3. 对每篇文章提取 3 个核心结论,并按照“技术突破、实战案例、行业动态”三分类整理为 Markdown 简报。
4. 将生成的简报自动格式化并存入 daily_reports/ 文件夹。
任务的持续执行依赖于智能体对环境的长期所有权。 只要沙盒保持活跃,定时触发器就会依照时间戳准时执行数据提取与格式化输出。
复杂计算与产物交付:端到端数据流水线
当任务跨越数据清洗、模型推理与最终报告渲染时,Work 智能体能够形成闭环的数据处理流水线。
用法 7:离线大数据清洗与自适应交互报告导出
处理数十万行级别的原始 CSV 时,直接上传会耗尽上下文窗口。Work 智能体通过在沙盒内运行流式处理脚本,仅将最终结果呈现给用户。
【提示词模板】
沙盒内已上传 500MB 的 raw_telemetry.csv,请执行流式处理流水线:
1. 使用 Python 的 Polars 库以分块流式方式读取文件,避免占用过多内存。
2. 过滤掉设备 ID 为空及校验和错误的脏数据,对传感器数值执行 Z-score 标准化。
3. 计算每个设备在时间窗口内的滑动平均值,并将聚合结果导出为 SQLite 数据库文件。
4. 编写一个轻量级 HTML 文件,使用 Chart.js 绑定该 SQLite 数据,生成可供离线点击交互的分析报告。
智能体直接在容器内完成所有密集型计算,用户最终只需下载打包好的 HTML 报告与 SQLite 数据库文件,无需消耗本地算力。
综合判断与认知纠偏
评估 ChatGPT Work 智能体时,必须明确它不是简单的界面交互增强工具,而是一个具备操作系统控制权的任务执行终端。
常见误读认为只要给大模型配上浏览器和代码执行环境,就能完全替代专业开发者的工程实现。实际情况是,Work 智能体依然受到上下文窗口大小、长任务随机异常以及复杂反爬机制的物理制约。它的核心价值在于将过去需要编写胶水代码并配置服务器环境的零散任务,压缩为一段明确的自然语言指令。 它负责消除繁琐的中间层,但业务逻辑的准确性仍然需要结构化提示词进行严谨约束。
一个未解决的问题
沙盒环境虽然具备持久化特性,但跨会话状态同步与长生命周期安全性之间的平衡仍未彻底解决。当后台运行的脚本需要长期存活并持有第三方敏感凭证时,如何在保证自动化调度不中断的前提下,实现细粒度的网络外联白名单控制与凭证内存隔离,依然是当前架构需要面对的技术挑战。
引用来源
- Simon Willison. "Understanding ChatGPT Work." Simon Willison's Weblog. 2026-08-30. https://simonwillison.net/2026/Aug/30/understanding-chatgpt-work/
- OpenAI. "Get started with ChatGPT Work." ChatGPT Learn 官方文档. 2026-08. https://learn.chatgpt.com/docs/get-started-with-work
- OpenAI. "Browser." ChatGPT Learn 官方文档. 2026-08. https://learn.chatgpt.com/docs/browser?surface=web
- OpenAI. "Introducing ChatGPT agent: bridging research and action." OpenAI 官方公告. 2026-08. https://openai.com/index/introducing-chatgpt-agent/
- OpenAI. "What's new." ChatGPT Learn 官方更新日志. 2026-08. https://learn.chatgpt.com/docs/whats-new


